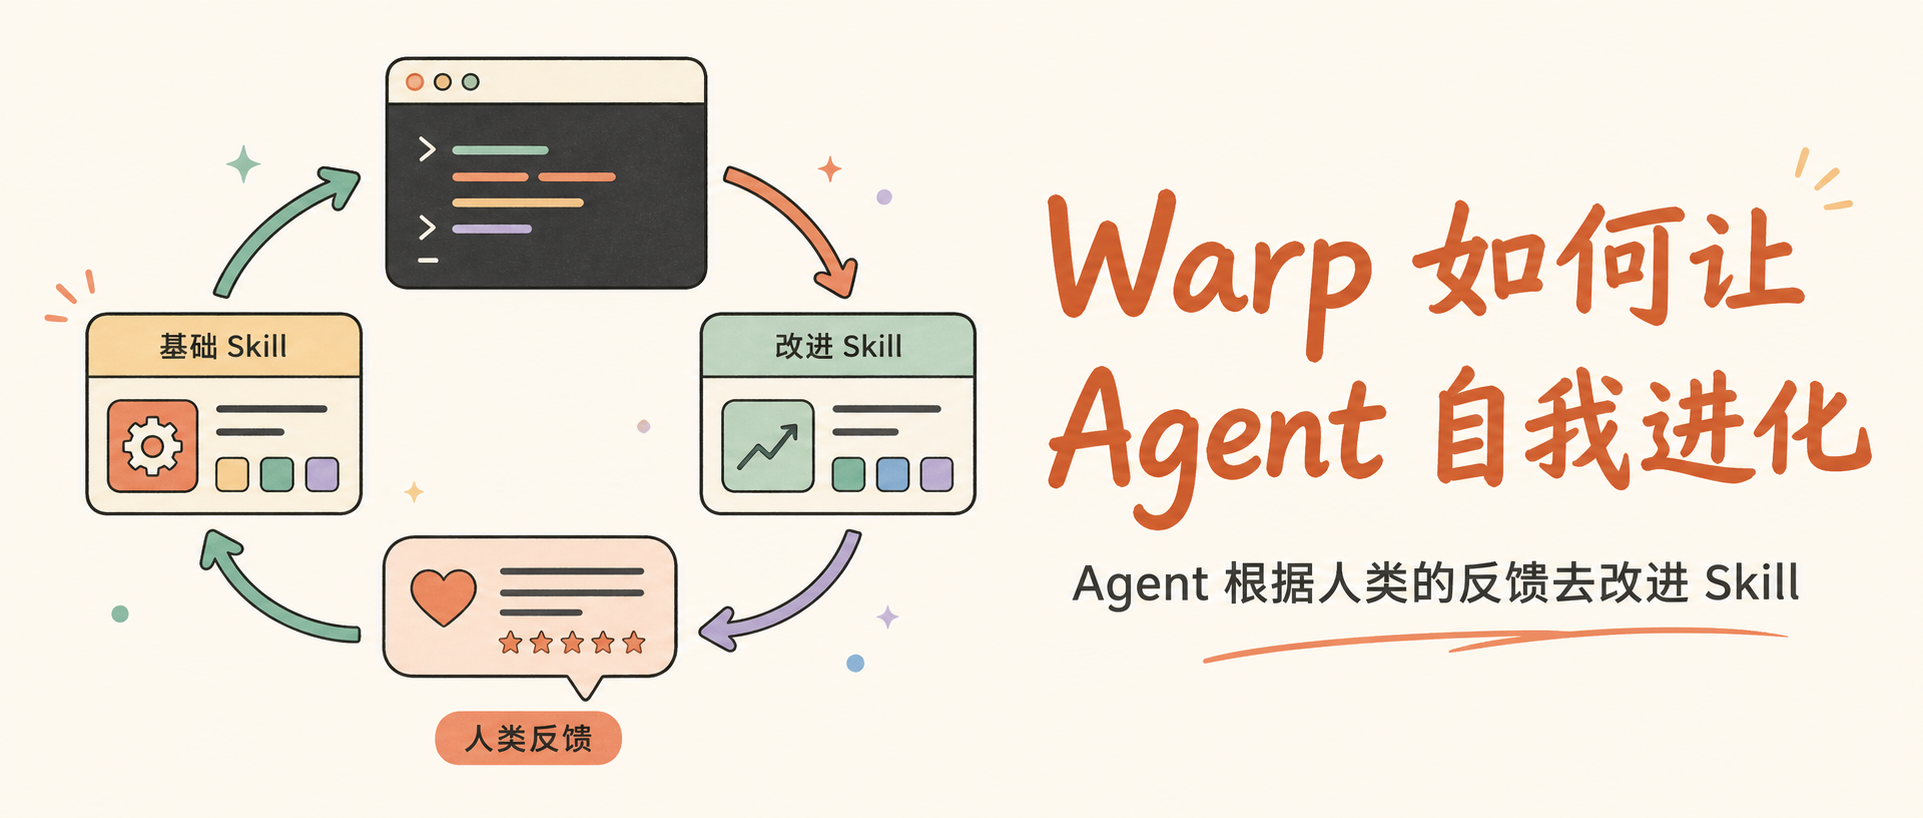
Warp 如何让 Agent 自我进化(How Warp builds self-improving agents on Claude 中译)
摘要中文导览(来自条目评分时的双语摘要,基于原文提炼):
- Anthropic 博客《How Warp builds self-improving agents on Claude》中译:Warp 内部用 Claude 做代码审查时发现缺的不是模型能力而是记忆——agent 不了解项目、团队规范与历史教训,指出过的问题下次照犯。方案是两个 Skill 加人类反馈闭环:一个基础 Skill 负责审查,一个改进 Skill 定期收集工程师在 PR 上对 agent 审查结果的评论并据此更新审查 Skill;摩擦被压到极低——人只要自然写评论,收集与更新全部自动完成。配套六条最佳实践:写原则而非死规则、解释规则背后的为什么、反馈收集零摩擦、Skill 保持精简并渐进式披露、反馈质量重于数量(资深工程师的少量详细反馈胜过大量草率反馈)、把“改进 Skill 的 Skill”做成可复用机制。对错误反馈的防线:不让 agent 盲目接受反馈、给足上下文做合理性检查、限制谁的反馈有权影响更新、始终保留人审。
文章信息
- 作者: 宝玉(译)/ Anthropic
- 发布: 2026-08-28
- 原文链接: https://baoyu.io/blog/2026-08-28/warp-self-improving-agents
- 原文(英文): https://claude.com/blog/how-warp-builds-self-improving-agents-on-claude
- 标签:
skillsself-improvementcode-reviewfeedback-loopagent-workflow
原文摘录(开头)
Agent 做 Code Review,缺的不是能力,而是记忆
说回来 Warp 这个,Warp 是一个挺有名的终端工具,内部尝试借助 AI 做 Code Review。一开始让 Agent review 代码,效果并不理想,主要问题体现在 Agent 不了解你的项目,不知道你的团队规范,不知道历史经验教训,就算你指出来问题它下次还记不住。简单来说就是没有记忆。
初期他们采取了很多补救措施:
- 手动根据失败案例改系统提示词
- 完善项目的
AGENTS.md文件(有意思的是这篇文章是 Claude 发的,但是用的是AGENTS.md而不是CLAUDE.md,我记得 Claude 默认不支持AGENTS.md的)
但效果并不理想,一方面它依赖于人主动去做,成本较高;另一方面团队成员在 Code Review 时人工在 PR 写的高质量评论完全没用上。
两个 Skill,加上人类反馈
所以他们搞了个解决方案,一个基础 Skill 负责做代码审查,一个改进 Skill 负责定期收集人类工程师在代码审查时的评论,尤其是对 Agent 审查结果的评论,根据人类工程师的评论去更新代码审查的 Skill。
换句话说,它不是依赖于模型自己去改进自己,而是 Agent 根据人类对模型结果的标注(人类对代码审查的评论),去改进技能。
只不过它把这个事做的摩擦力极低,不需要人手工去收集整理评论,不需要填写调查问卷,人只要自然地去代码下写评论,后面的事情都是 Agent 自动完成。
这可能正是 Agent 的最佳实践方案之一:人负责高维度的标注、评论、反馈这些事情,Agent 去做执行的工作,Agent 根据人类的反馈去改进 Skill。
Warp 总结的 6 条最佳实践
除此之外,他们还总结了一些最佳实践:
1\. 写原则,不要写死规则
编写 Skill 时,要像在指导一个聪明人,而不是在给计算机编程。在 Skill 中写“寻找重复代码”,比列出详尽的变量命名规则更有效。
2\. 解释为什么
说明规则背后的理由,能让智能体针对问题进行推理,而不是机械执行僵化指令,也因此更容易举一反三。
3\. 让反馈没有摩擦、毫不费力
在人们原本工作的地方收集反馈,例如直接评论 PR 或 issue。同时让收集过程自动发生,不要增加额外的提交步骤。低摩擦才能让信号持续流动。如果反馈太麻烦,你就收不到反馈,也就无法改进 Skill。
4\. 保持 Skill 精简,并使用渐进式披露
优秀的 Skill 文件不会很庞大;它会引用资源文件和脚本,而不是一次性把所有内容都塞进上下文。
Summary (EN)
A Chinese translation of Anthropic's How Warp builds self-improving agents on Claude: Warp found code-review agents lacked memory, not capability — they ignored project context and repeated flagged mistakes. The fix pairs two skills with a human-feedback loop: a base review skill plus an improver skill that periodically harvests engineers' PR comments on agent reviews and updates the review skill accordingly, with near-zero friction (people just comment naturally). Six best practices: prefer principles over rigid rules, explain the why, make feedback frictionless, keep skills lean with progressive disclosure, favor quality over quantity of feedback, and build the skill-improving skill as a reusable mechanism. Guardrails against bad feedback: sanity checks with context, restricted influence, and a human review loop.
Obsidian 证据摘录
入选自 Obsidian Gracker RSS 2026-08-31 抓取的宝玉译稿:Warp 用人类反馈闭环改进 code review Skill 的六条实践。